KI-Crawler / KI-Crawler
Google-Agent: Aufgabe und Wirkung einer Sperre
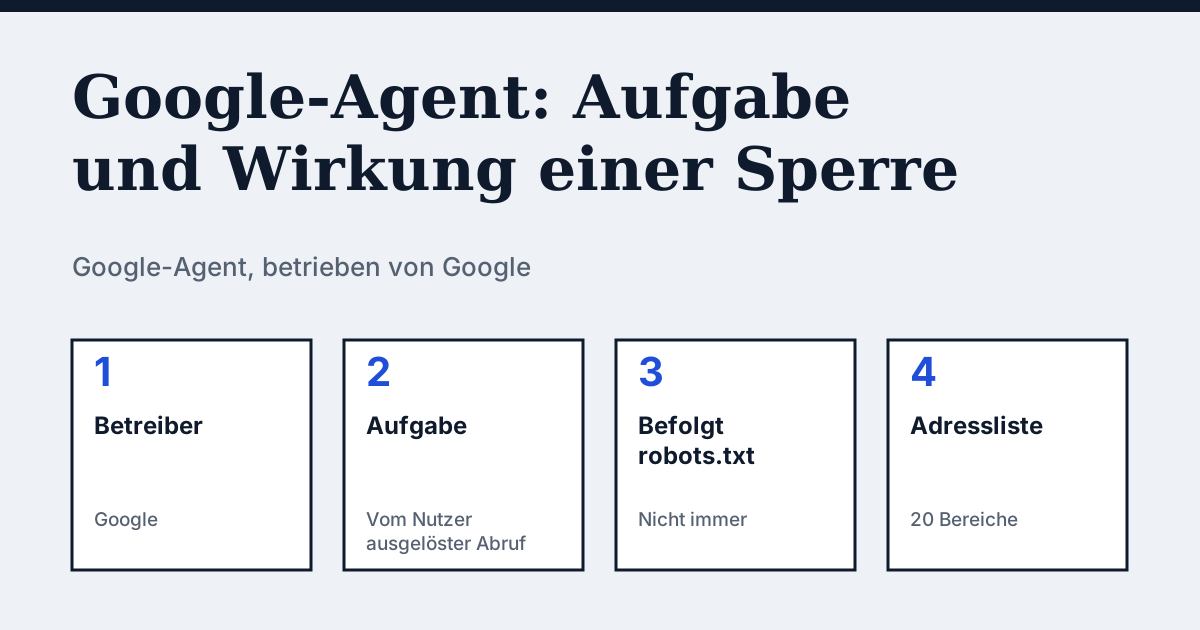
Was Google-Agent ist
Google-Agent ist ein vom Nutzer ausgelöster Fetcher, den laut Google Agenten auf Googles Infrastruktur verwenden, um im Web zu navigieren und auf Wunsch eines Nutzers Aktionen auszuführen. Google nennt getrennte User-Agent-Strings für Mobil und Desktop. Google sagt außerdem, es experimentiere mit dem Protokoll Web Bot Auth und nutze dafür die Identität https://agent.bot.goog.
| Angabe | Google-Agent |
|---|---|
| Betreiber | |
| Aufgabe | Vom Nutzer ausgelöster Abruf (Agenten, die für einen Nutzer handeln) |
| robots.txt-Token | Google-Agent |
| Befolgt robots.txt | Teilweise. Google sagt, vom Nutzer ausgelöste Fetcher ignorieren robots.txt-Regeln in der Regel, weil ein Nutzer den Abruf angefordert hat. |
| IP-Adressen | 20 Bereiche (developers.google.com/static/crawling/ipranges/user-triggered-agents.json, Datei vom 2026-10-23) |
| Seite des Betreibers gelesen am | 24. Oktober 2026 |
Was der Betreiber sagt
Die Worte des Betreibers (englisches Original): “Google-Agent is used by agents hosted on Google infrastructure to navigate the web and perform actions upon user request.”
Quelle: Google Search Central: Google user-triggered fetchers, gelesen am 24. Oktober 2026.
Was passiert, wenn Sie Google-Agent sperren
Google sagt, dass vom Nutzer ausgelöste Fetcher robots.txt-Regeln in der Regel ignorieren, weil der Abruf von einem Nutzer angefordert wurde. Die Google-Seite dokumentiert kein robots.txt-Token für Google-Agent.
Die robots.txt-Zeilen
So erlauben Sie Google-Agent:
User-agent: Google-Agent
Allow: /
So sperren Sie Google-Agent:
User-agent: Google-Agent
Disallow: /
Fügen Sie einen Block in die robots.txt im Stammverzeichnis Ihres Hosts ein, zum Beispiel https://example.com/robots.txt. Eine Gruppe für ein Token gilt nicht für die anderen Crawler desselben Betreibers.
Der User-Agent-String laut Betreiber:
Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko; compatible; Google-Agent; +https://developers.google.com/crawling/docs/crawlers-fetchers/google-agent) Chrome/W.X.Y.Z Safari/537.36Woran Sie eine echte von einer gefälschten Anfrage unterscheiden
Die Datei developers.google.com/static/crawling/ipranges/user-triggered-agents.json enthielt am 24. Oktober 2026 20 Bereiche, Datei vom 2026-10-23.
Google sagt, Google-Agent nutze IP-Bereiche aus user-triggered-agents.json, und die Reverse-DNS-Maske der vom Nutzer ausgelösten Fetcher entspreche *-*-*-*.gae.googleusercontent.com oder google-proxy-*-*-*-*.google.com, je nachdem, ob der Fetcher Google oder einem Nutzer gehört.
Vergleich mit ChatGPT-User
ChatGPT-User: Beide handeln auf Anfrage eines Nutzers, statt von sich aus zu crawlen, und Google-Agent wird so beschrieben, dass er im Web navigiert und Aktionen für den Nutzer ausführt.
Ihre eigene Website
Der kostenlose Check im Kasten oben testet acht Crawler (GPTBot, OAI-SearchBot, ChatGPT-User, PerplexityBot, ClaudeBot, Google-Extended, Bingbot und Googlebot). Google-Agent gehört nicht dazu: Lesen Sie Ihre robots.txt auf eine Gruppe Google-Agent und suchen Sie den User-Agent in Ihrem Server-Log. Die vollständige Liste der Crawler steht im KI-Crawler-Verzeichnis.
Häufige Fragen
Befolgt Google-Agent die robots.txt?
Nicht immer. Teilweise. Google sagt, vom Nutzer ausgelöste Fetcher ignorieren robots.txt-Regeln in der Regel, weil ein Nutzer den Abruf angefordert hat. Eine Regel für Google-Agent in der robots.txt hält ihn deshalb möglicherweise nicht auf. Um ihn sicher abzuweisen, nutzen Sie eine Firewall- oder CDN-Regel, die User-Agent und veröffentlichte Adressen kombiniert.
Woher weiß ich, dass Google-Agent wirklich gesperrt ist?
Die robots.txt ist nur eine Ebene: Auch eine CDN- oder Firewall-Regel kann einen Crawler abweisen, und ein Crawler kann die Datei ignorieren. Suchen Sie den User-Agent in Ihrem Server-Log und testen Sie die Adresse von außerhalb Ihres Netzes.
Quellen
- Google Search Central: Google user-triggered fetchers
- Google: user-triggered-agents.json (read 2026-10-24, creationTime 2026-10-23)
- Google Search Central: Overview of Google crawlers and fetchers
Sehen Sie, was KI über Ihren Shop antwortet
Das Audit crawlt Ihre Website bis zum Seitenlimit Ihres Tarifs, zeigt, welche KI-Crawler hereinkommen, und liefert die genaue Korrektur. Ab 9 €, 14 Tage Geld-zurück-Garantie.
Meine Seite prüfenAudit ab 9 €, einmal bezahlt. 14 Tage Geld-zurück-Garantie.