Guías / Rastreo
¿Está bloqueado GPTBot en mi web? Cuatro sitios donde mirar y una prueba para cada uno
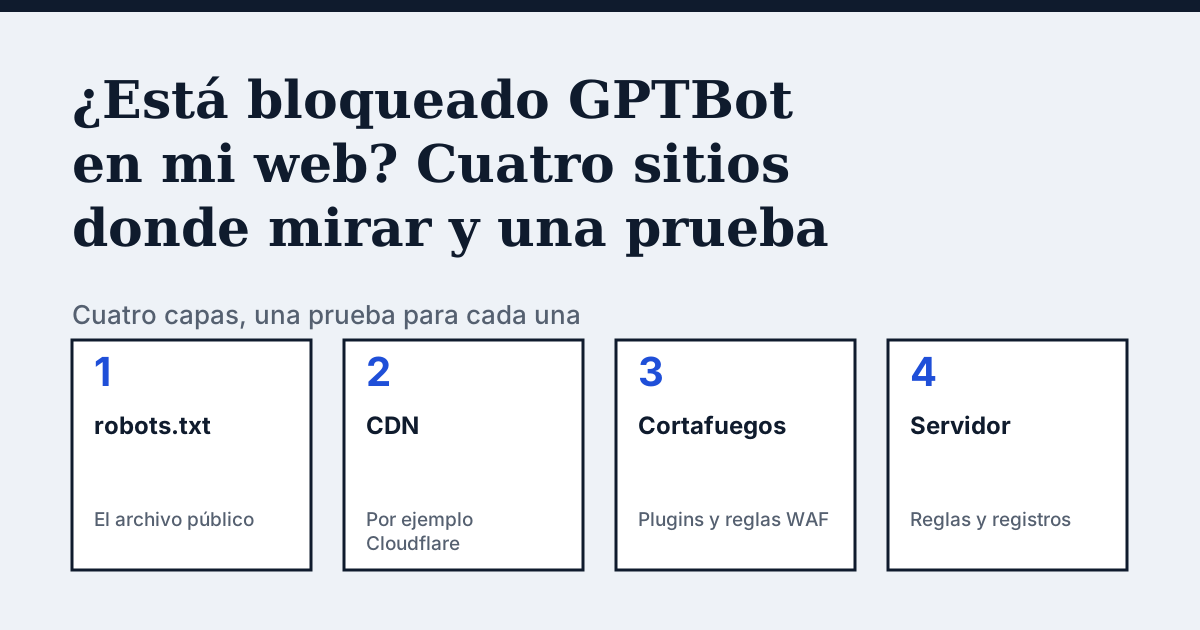
¿En qué cuatro sitios puede frenarse a GPTBot?
GPTBot es el rastreador que, según OpenAI, usa para recopilar contenido que puede servir para entrenar sus modelos. Una petición suya puede rechazarse en cuatro capas, y cada una necesita su propia prueba: el archivo robots.txt, tu CDN, un plugin de seguridad o regla de cortafuegos (WAF) y una regla del servidor web.
La auditoría de CitedBy, desde 9 €, cubre la primera. Las otras tres pueden devolver un código de error aunque robots.txt diga que sí.
¿Cómo comprobarlo, paso a paso?
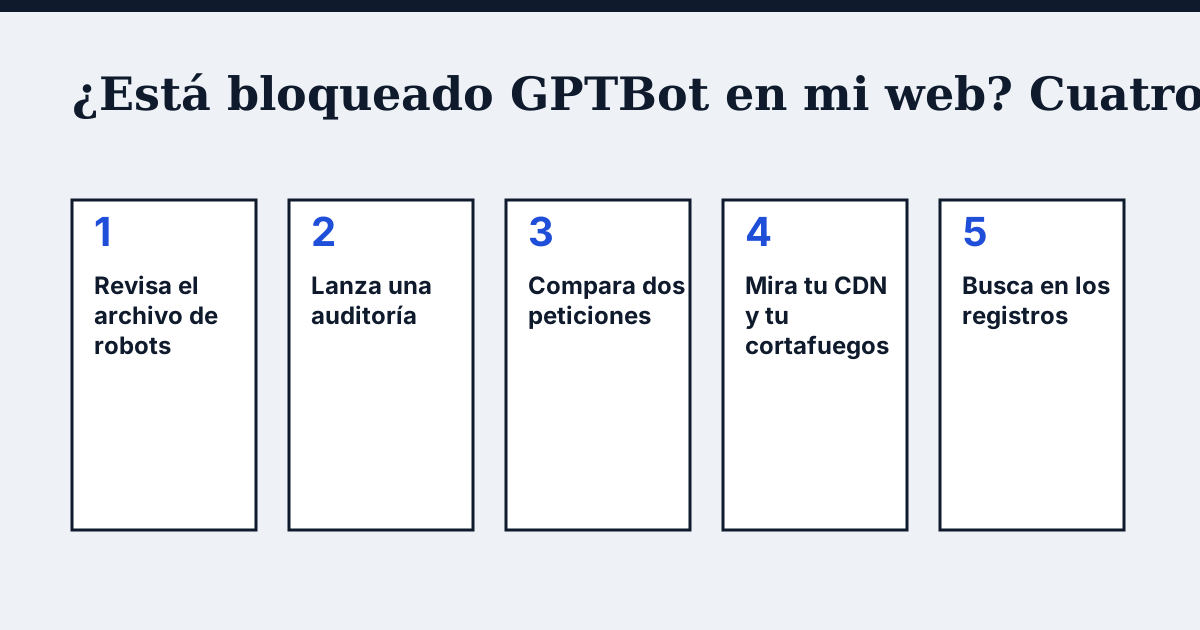
- Revisa el archivo de robots: abre
tutienda.es/robots.txten el navegador y busca un grupo que nombreGPTBot. Si no hay ninguno, GPTBot sigue el grupoUser-agent: *, así que unDisallow: /general también le afecta (RFC 9309). - Lanza una auditoría: la de CitedBy lee robots.txt para GPTBot, OAI-SearchBot, PerplexityBot, Google-Extended y Bingbot y te dice cuáles están bloqueados.
- Compara dos peticiones: envía dos peticiones a tu página de inicio, una normal y otra con el agente de usuario de GPTBot, y compara los códigos de estado. Los comandos están abajo.
- Mira tu CDN y tu cortafuegos: entra en el panel de tu CDN y busca los ajustes de rastreadores de IA; en el plugin de seguridad o en la lista de reglas, busca
GPTBot,bot,AIycrawler. - Busca en los registros: filtra los logs de tu servidor por
GPTBot. Una serie de respuestas 403 es la señal de un bloqueo que robots.txt no muestra.
¿Cómo funciona la prueba de las dos peticiones?
Sustituye tutienda.es por tu dirección. El primer comando envía una petición normal; el segundo, el agente de usuario de GPTBot que publica OpenAI. Cada uno imprime solo el código de estado.
curl -s -o /dev/null -w "%{http_code}\n" https://tutienda.es/
curl -s -o /dev/null -w "%{http_code}\n" -A "Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; GPTBot/1.4; +https://openai.com/gptbot" https://tutienda.es/
Un 403 solo en la segunda petición indica que una regla apunta al nombre del rastreador.
Hay un límite. La prueba sale de tu ordenador. Si tu hosting también juzga a los rastreadores por su dirección IP, el GPTBot real puede recibir otra respuesta distinta a la que has visto. OpenAI publica los rangos de IP de GPTBot en openai.com/gptbot.json, así que tus registros pueden mostrar si las peticiones desde esos rangos pasaron (documentación de OpenAI).
¿Dónde se ajusta en Cloudflare?
La documentación de Cloudflare indica los pasos: entra en tu dominio, abre AI Crawl Control y ve a la pestaña Security. La pestaña Crawlers muestra los rastreadores de IA que piden tu contenido. En la columna Actions eliges Allow o Block para cada uno, y con Allow puedes seguir aplicando robots.txt (Cloudflare: gestionar rastreadores de IA).
Los valores por defecto también cambian. Help Net Security informa de que, desde el 15 de septiembre de 2026, los dominios nuevos bloquean por defecto los rastreadores de entrenamiento y de agentes en las páginas que muestran anuncios, y los de búsqueda siguen permitidos (Help Net Security). Mira tu propio panel en lugar de dar por hecho qué valor recibió tu dominio.
¿Qué hacer si la web rechaza la petición?
Una petición normal de nuestra comprobación también puede ser rechazada. Si la respuesta es HTTP 403, 429 o 503, la comprobación lo indica y avisa de que desde fuera no puede saber si también se rechaza a los rastreadores de IA. Un 403 suele significar que una regla bloqueó la petición. Un 429 o un 503 pueden indicar también límite de peticiones o una caída, que afecta a todos los visitantes. Corrige la causa en el CDN, el cortafuegos o el panel del hosting y vuelve a comprobar.
¿Debes desbloquear GPTBot?
Es decisión tuya, y bloquearlo es una opción legítima. OpenAI lista GPTBot, OAI-SearchBot y ChatGPT-User como rastreadores distintos con funciones distintas. GPTBot es para datos de entrenamiento. OAI-SearchBot muestra webs en las funciones de búsqueda de ChatGPT. ChatGPT-User visita páginas cuando una persona pregunta por ellas.
| Tu objetivo | Qué hacer |
|---|---|
| Salir en la búsqueda de ChatGPT sin que se entrene con tu contenido | Permite OAI-SearchBot y bloquea GPTBot |
| Salir en la búsqueda de ChatGPT y permitir el entrenamiento | Permite ambos |
| Quedarte fuera de los dos | Bloquea ambos y revisa tus registros por ChatGPT-User |
Según OpenAI, un cambio en robots.txt puede tardar unas 24 horas en llegar a OAI-SearchBot.
Preguntas frecuentes
¿Bloquear GPTBot saca mi tienda online de ChatGPT?
No por sí solo. OpenAI describe OAI-SearchBot como el rastreador de las funciones de búsqueda de ChatGPT y GPTBot como el de entrenamiento, cada uno configurado por separado en robots.txt.
¿Por qué robots.txt parece correcto pero GPTBot recibe un 403?
robots.txt es una petición al rastreador. Un CDN, un cortafuegos o una regla del servidor pueden rechazar la petición igualmente, así que revisa esas capas con la prueba de las dos peticiones y con tus registros.
¿Respeta ChatGPT-User el archivo robots.txt?
OpenAI indica que las reglas de robots.txt pueden no aplicarse a ChatGPT-User, porque las peticiones las inicia una persona.
¿Me recomendará ChatGPT si desbloqueo GPTBot?
No. Que te puedan leer es la entrada, no el resultado. Que un asistente nombre tu tienda depende de lo que encuentre sobre tu categoría, y eso lo mide la auditoría de CitedBy con preguntas reales de compradores.
Fuentes
- OpenAI: rastreadores y agentes de usuario, rangos de IP
- Cloudflare: gestionar rastreadores de IA
- Help Net Security: Cloudflare cambia las reglas de acceso de rastreadores de IA, 2 de julio de 2026
- IETF RFC 9309: protocolo de exclusión de robots
Mira qué responde la IA sobre tu tienda
La auditoría rastrea cada página de tu web, muestra qué rastreadores de IA entran y da la corrección exacta. Desde 9 €, garantía de 14 días.
Auditar mi webAuditoría desde 9 €, pago único. Fix Pack 390 € pago único. Garantía de 14 días.