Rastreadores de IA / Rastreadores de IA
ClaudeBot: qué hace y qué cambia si lo bloqueas
Qué es ClaudeBot
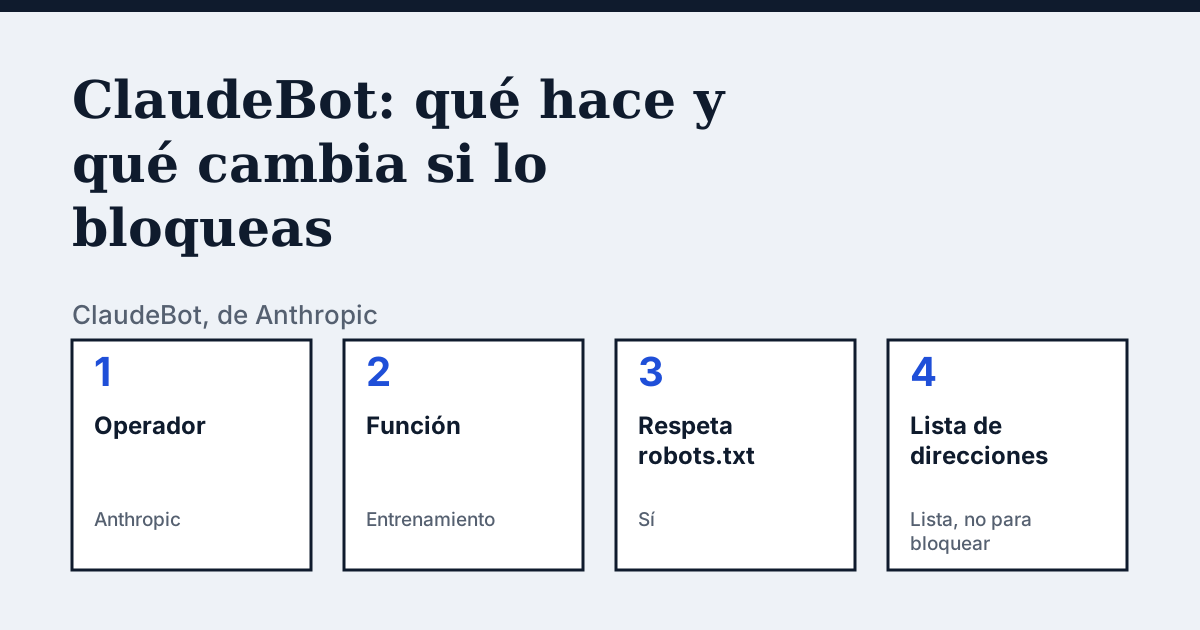
Anthropic nombra tres robots en su artículo de ayuda: ClaudeBot para datos de entrenamiento, Claude-User para páginas que se obtienen a petición de un usuario y Claude-SearchBot para la calidad de la búsqueda. ClaudeBot es el de entrenamiento. El artículo tiene fecha de 7 de abril de 2026.
| Dato | ClaudeBot |
|---|---|
| Operador | Anthropic |
| Función | Entrenamiento |
| Token de robots.txt | ClaudeBot |
| Respeta robots.txt | Sí, sigue robots.txt y Crawl-delay |
| Direcciones IP | El proveedor remite a una lista pero desaconseja bloquear por IP |
| Página del proveedor leída el | 21 de octubre de 2026 |
Qué dice el proveedor
En palabras del proveedor (original en inglés): “ClaudeBot helps enhance the utility and safety of our generative AI models by collecting web content that could potentially contribute to their training. When a site restricts ClaudeBot access, it signals that the site's future materials should be excluded from our AI model training datasets.”
Fuente: Anthropic Help Center: Does Anthropic crawl data from the web, and how can site owners block the crawler? (7 April 2026), leído el 21 de octubre de 2026.
Qué pasa si bloqueas ClaudeBot
Anthropic dice que una restricción indica que los materiales futuros del sitio deben excluirse de sus conjuntos de datos de entrenamiento. La redacción dice «materiales futuros»; no dice qué pasa con el contenido ya recogido. Los otros dos robots de Claude son independientes, así que bloquear ClaudeBot no toca sus reglas.
Las líneas de robots.txt
Para permitir ClaudeBot:
User-agent: ClaudeBot
Allow: /
Para bloquear ClaudeBot:
User-agent: ClaudeBot
Disallow: /
Pega un bloque en el robots.txt de la raíz de tu host, por ejemplo https://example.com/robots.txt. Un grupo para un token no cubre los demás rastreadores del mismo operador.
La página del proveedor no muestra una cadena user-agent completa para ClaudeBot.
Cómo distinguir una petición real de una falsa
El artículo de Anthropic dice que sus robots respetan las señales de «no rastrear» de robots.txt y que no intentarán saltarse los CAPTCHA. Admite la directiva no estándar Crawl-delay, por ejemplo User-agent: ClaudeBot seguido de Crawl-delay: 1. Dice también que bloquear por dirección IP puede no dar una exclusión duradera, porque impide que el robot lea robots.txt. El artículo de Anthropic indica que robots.txt debe configurarse en cada subdominio del que quieras excluirte.
Compara con Claude-SearchBot
Claude-SearchBot: Un robot de búsqueda aparte: bloquear ClaudeBot no le afecta.
Tu propio sitio
La comprobación gratuita del recuadro de arriba prueba ClaudeBot con una petición real y lee robots.txt para él. La lista completa de rastreadores está en el directorio de rastreadores de IA.
Preguntas frecuentes
¿ClaudeBot respeta robots.txt?
Sí, sigue robots.txt y Crawl-delay. Dale a ClaudeBot su propio grupo User-agent en robots.txt: los demás rastreadores del mismo operador tienen cada uno su ajuste.
¿Cómo sé que ClaudeBot está realmente bloqueado?
robots.txt es solo una capa: una regla de CDN o de cortafuegos también puede rechazar a un rastreador, y un rastreador puede ignorar el archivo. Busca el user agent en el registro de tu servidor y prueba la dirección desde fuera de tu red.
Fuentes
Mira qué responde la IA sobre tu tienda
La auditoría rastrea tu web hasta el límite de páginas de tu plan, muestra qué rastreadores de IA entran y da la corrección exacta. Desde 9 €, garantía de 14 días.
Auditar mi webAuditoría desde 9 €, pago único. Garantía de 14 días.