Rastreadores de IA / Rastreadores de IA
Google-Extended: qué hace y qué cambia si lo bloqueas
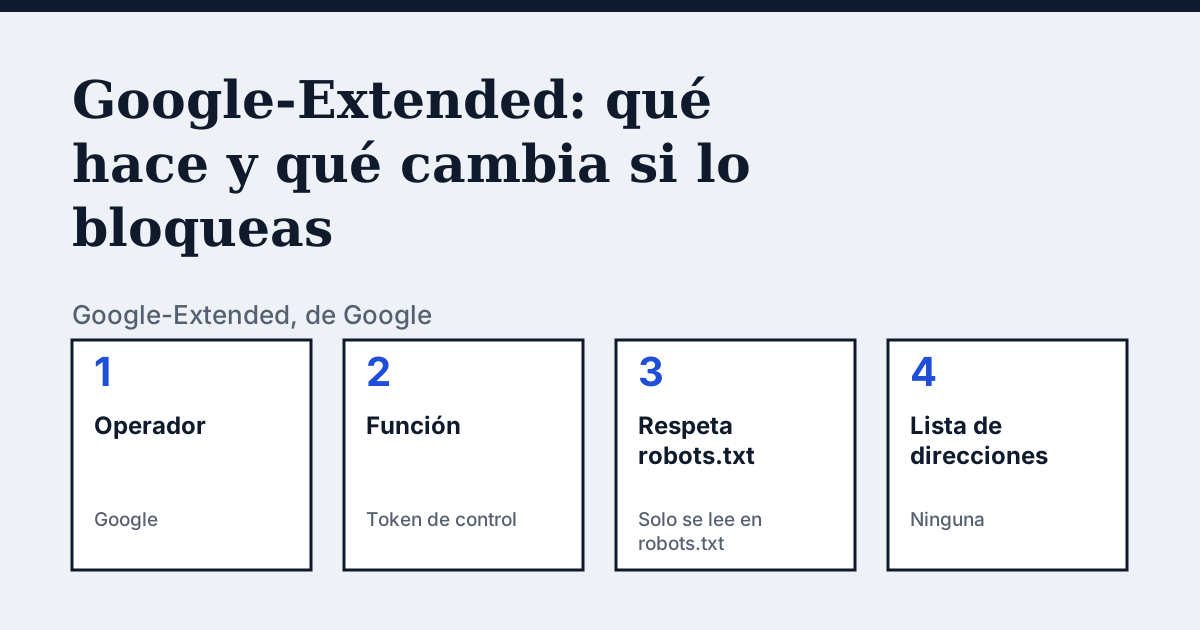
Qué es Google-Extended
La mayoría de las páginas de este conjunto describen un rastreador que puedes encontrar en un registro. Este no. Google afirma que Google-Extended «no tiene una cadena de agente de usuario de solicitud HTTP independiente»: el rastreo se hace con los agentes de usuario de Google que ya existen, y el token de robots.txt se usa como control.
| Dato | Google-Extended |
|---|---|
| Operador | |
| Función | Token de control (sin solicitudes propias) |
| Token de robots.txt | Google-Extended |
| Respeta robots.txt | Solo se lee en robots.txt; no hay un agente de usuario aparte |
| Direcciones IP | Ninguna: nunca descarga páginas |
| Página del proveedor leída el | 21 de octubre de 2026 |
Qué dice el proveedor
En palabras del proveedor (original en inglés): “Google-Extended is a standalone product token that web publishers can use to manage whether content Google crawls from their sites may be used for training future generations of Gemini models that power Gemini Apps and Vertex AI API for Gemini. Google-Extended does not impact a site's inclusion in Google Search nor is it used as a ranking signal in Google Search.”
Fuente: Google Search Central: Google's common crawlers (last updated 2026-10-15), leído el 21 de octubre de 2026.
Qué pasa si bloqueas Google-Extended
Añadir Disallow: / bajo Google-Extended le indica a Google que no puede usar el contenido para entrenar futuros modelos de Gemini que hay detrás de Gemini Apps y de la API de Vertex AI para Gemini. Google dice también que no afecta a la inclusión en Google Search y que no es una señal de posicionamiento. Nuestra auditoría lee este token en robots.txt como una de sus comprobaciones; es la única señal que hay.
Las líneas de robots.txt
Para permitir Google-Extended:
User-agent: Google-Extended
Allow: /
Para bloquear Google-Extended:
User-agent: Google-Extended
Disallow: /
Pega un bloque en el robots.txt de la raíz de tu host, por ejemplo https://example.com/robots.txt. Un grupo para un token no cubre los demás rastreadores del mismo operador.
Cómo distinguir una petición real de una falsa
No hay nada que verificar en la capa de red: ni agente de usuario ni lista de direcciones. Revisa el propio robots.txt, en cada host, y recuerda que una búsqueda en los registros de Google-Extended no encuentra nada, lo bloquees o no. El grupo de ejemplo de Google muestra que el token admite una ruta permitida y una ruta bloqueada como cualquier otro.
Google-Extended no envía peticiones por sí mismo, así que nunca aparece en el registro de tu servidor. Solo se lee en robots.txt.
Compara con Googlebot
Googlebot: El rastreador que de verdad obtiene tus páginas para Search.
Tu propio sitio
La comprobación gratuita del recuadro de arriba prueba Google-Extended con una petición real y lee robots.txt para él. La lista completa de rastreadores está en el directorio de rastreadores de IA.
Preguntas frecuentes
¿Google-Extended respeta robots.txt?
Solo se lee en robots.txt; no hay un agente de usuario aparte. No envía peticiones por sí mismo, así que no hay nada que bloquear en el cortafuegos: la regla de robots.txt es todo el control.
¿Cómo sé que Google-Extended está realmente bloqueado?
robots.txt es solo una capa: una regla de CDN o de cortafuegos también puede rechazar a un rastreador, y un rastreador puede ignorar el archivo. Busca el user agent en el registro de tu servidor y prueba la dirección desde fuera de tu red.
Fuentes
Mira qué responde la IA sobre tu tienda
La auditoría rastrea tu web hasta el límite de páginas de tu plan, muestra qué rastreadores de IA entran y da la corrección exacta. Desde 9 €, garantía de 14 días.
Auditar mi webAuditoría desde 9 €, pago único. Garantía de 14 días.