Rastreadores de IA / Rastreadores de IA
Meta-ExternalFetcher: qué hace y qué cambia si lo bloqueas
Qué es Meta-ExternalFetcher
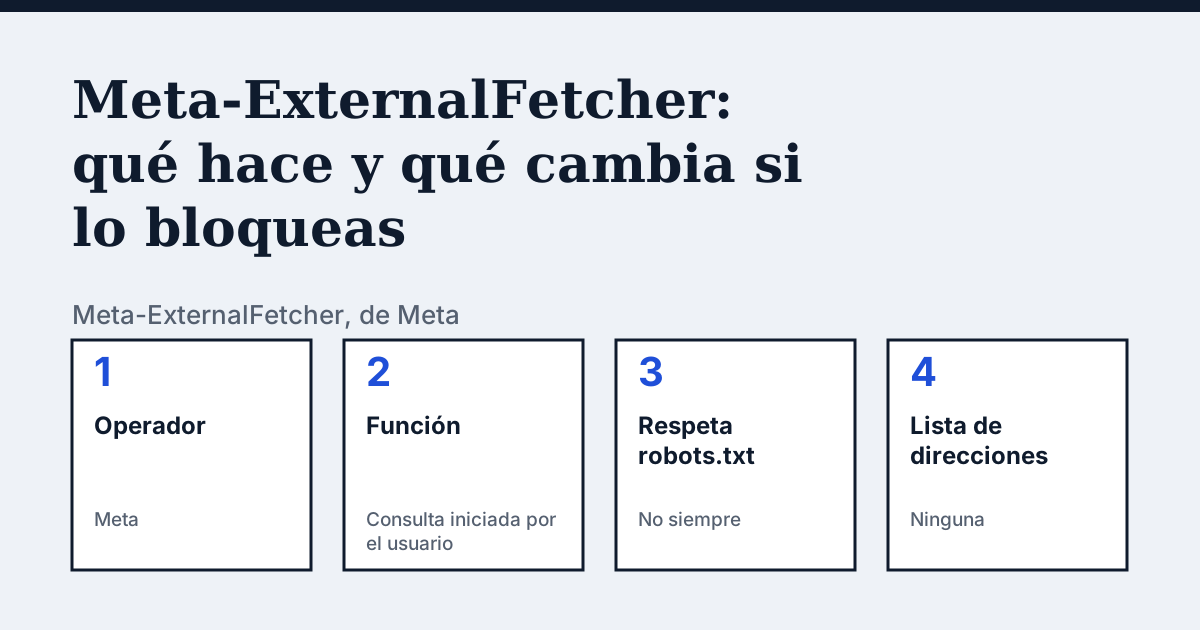
Meta-ExternalFetcher es un rastreador de Meta que obtiene enlaces concretos a petición de un usuario. Meta dice que da soporte a funciones de producto como evaluar y mejorar las capacidades de IA agéntica, incluido ayudar a la IA a navegar por sitios web para completar tareas de los usuarios. Meta lo documenta junto con Meta-ExternalAgent, Meta-WebIndexer, Meta-ExternalAds y FacebookExternalHit en una sola página.
| Dato | Meta-ExternalFetcher |
|---|---|
| Operador | Meta |
| Función | Consulta iniciada por el usuario |
| Token de robots.txt | Meta-ExternalFetcher |
| Respeta robots.txt | Parcial, puede saltarse robots.txt porque las consultas las pide un usuario |
| Direcciones IP | Ninguna publicada |
| Página del proveedor leída el | 24 de octubre de 2026 |
Qué dice el proveedor
En palabras del proveedor (original en inglés): “The Meta-ExternalFetcher crawler fetches individual links at a user's request and supports product functions such as evaluating and improving agentic AI capabilities—including helping AI navigate websites to complete tasks for users. Accordingly, this crawler may bypass robots.txt rules.”
Fuente: Meta: Meta Web Crawlers, leído el 24 de octubre de 2026.
Qué pasa si bloqueas Meta-ExternalFetcher
Meta dice que puedes bloquear sus rastreadores añadiendo a robots.txt un disallow para el rastreador correspondiente. Meta dice también que Meta-ExternalFetcher puede saltarse robots.txt porque hace consultas que pidió el usuario. Meta dice que los cambios en robots.txt pueden tardar hasta 24 horas en surtir efecto porque los rastreadores pueden guardar el archivo en caché hasta 24 horas.
Las líneas de robots.txt
Para permitir Meta-ExternalFetcher:
User-agent: Meta-ExternalFetcher
Allow: /
Para bloquear Meta-ExternalFetcher:
User-agent: Meta-ExternalFetcher
Disallow: /
Pega un bloque en el robots.txt de la raíz de tu host, por ejemplo https://example.com/robots.txt. Un grupo para un token no cubre los demás rastreadores del mismo operador.
La cadena user-agent que muestra el proveedor:
meta-externalfetcher/1.1Cómo distinguir una petición real de una falsa
La página de rastreadores de Meta no enumera direcciones IP ni un método de verificación para este rastreador; lo identifica por su cadena de user-agent.
Compara con Meta-ExternalAgent
Meta-ExternalAgent: Meta-ExternalAgent rastrea la web en segundo plano, incluso para entrenar modelos fundacionales de IA, mientras que Meta-ExternalFetcher obtiene enlaces sueltos que un usuario pidió y puede saltarse robots.txt.
Tu propio sitio
La comprobación gratuita del recuadro de arriba prueba ocho rastreadores (GPTBot, OAI-SearchBot, ChatGPT-User, PerplexityBot, ClaudeBot, Google-Extended, Bingbot y Googlebot). Meta-ExternalFetcher no es uno de ellos: lee tu robots.txt buscando un grupo Meta-ExternalFetcher y busca el user agent en el registro de tu servidor. La lista completa de rastreadores está en el directorio de rastreadores de IA.
Preguntas frecuentes
¿Meta-ExternalFetcher respeta robots.txt?
No siempre. Parcial, puede saltarse robots.txt porque las consultas las pide un usuario. Por eso una regla para Meta-ExternalFetcher en robots.txt puede no detenerlo. Para rechazarlo con seguridad, usa una regla de cortafuegos o de CDN que combine el user agent y las direcciones publicadas.
¿Cómo sé que Meta-ExternalFetcher está realmente bloqueado?
robots.txt es solo una capa: una regla de CDN o de cortafuegos también puede rechazar a un rastreador, y un rastreador puede ignorar el archivo. Busca el user agent en el registro de tu servidor y prueba la dirección desde fuera de tu red.
Fuentes
Mira qué responde la IA sobre tu tienda
La auditoría rastrea tu web hasta el límite de páginas de tu plan, muestra qué rastreadores de IA entran y da la corrección exacta. Desde 9 €, garantía de 14 días.
Auditar mi webAuditoría desde 9 €, pago único. Garantía de 14 días.