Robots d'exploration IA / Robots d'exploration IA
CCBot : ce qu'il fait et ce que change son blocage
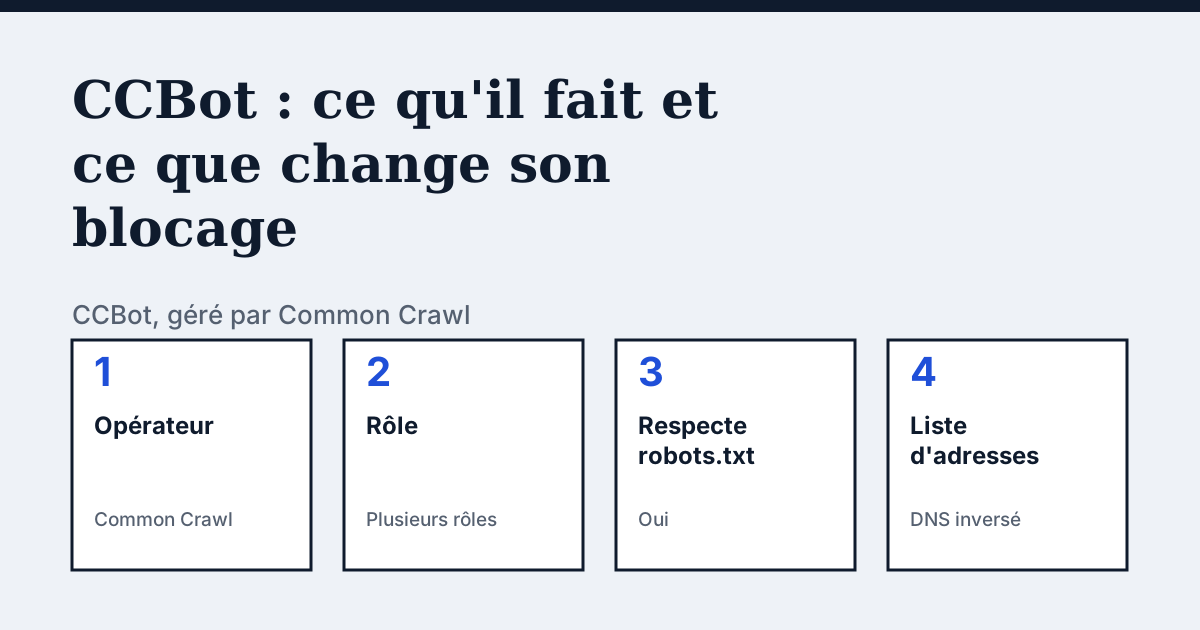
Ce qu'est CCBot
CCBot est le robot d’exploration de Common Crawl, une fondation à but non lucratif qui produit et tient un dépôt ouvert de données d’exploration du web, que chacun peut consulter et analyser. La page de l’opérateur indique que ces données sont destinées à être librement accessibles aux organisations, au monde universitaire et aux organisations à but non lucratif.
| Fait | CCBot |
|---|---|
| Opérateur | Common Crawl |
| Rôle | Archive publique d’exploration du web |
| Jeton robots.txt | CCBot |
| Respecte robots.txt | Oui, via une règle robots.txt pour CCBot |
| Adresses IP | Vérification par DNS inversé |
| Page de l'opérateur lue le | 24 octobre 2026 |
Ce que dit l'opérateur
Les mots de l'opérateur (original en anglais) : “To prevent Common Crawl from crawling your website, include the following in your robots.txt”
Source : Common Crawl: CCBot, lu le 24 octobre 2026.
Que se passe-t-il si vous bloquez CCBot
Common Crawl indique qu’ajouter User-agent: CCBot avec Disallow: / à robots.txt l’empêche d’explorer le site. La page précise aussi qu’elle a connaissance de robots qui se font passer à tort pour CCBot et recommande de vérifier les chaînes de user agent.
Les lignes robots.txt
Pour autoriser CCBot :
User-agent: CCBot
Allow: /
Pour bloquer CCBot :
User-agent: CCBot
Disallow: /
Collez un bloc dans le fichier robots.txt à la racine de votre hôte, par exemple https://example.com/robots.txt. Un groupe pour un jeton ne couvre pas les autres robots du même opérateur.
La chaîne user-agent indiquée par l'opérateur :
CCBot/2.0 (https://commoncrawl.org/faq/)Comment distinguer une vraie requête d'une fausse
Common Crawl indique que CCBot utilise des plages d’adresses IP dédiées avec DNS inverse (pas pour IPv6) : une requête enregistrée peut donc être vérifiée par une recherche inverse qui renvoie un nom d’hôte crawl.commoncrawl.org ; les plages sont aussi publiées en JSON sur https://index.commoncrawl.org/ccbot.json.
À comparer avec GPTBot
GPTBot : CCBot constitue une archive d’exploration publique que d’autres peuvent utiliser, tandis que GPTBot collecte du contenu pour les propres besoins d’OpenAI.
Votre propre site
Le contrôle gratuit dans l'encadré ci-dessus teste huit robots (GPTBot, OAI-SearchBot, ChatGPT-User, PerplexityBot, ClaudeBot, Google-Extended, Bingbot et Googlebot). CCBot n'en fait pas partie : lisez votre robots.txt pour un groupe CCBot et cherchez le user agent dans votre journal de serveur. La liste complète des robots est sur le répertoire des robots d'exploration IA.
Questions fréquentes
CCBot respecte-t-il robots.txt ?
Oui, via une règle robots.txt pour CCBot. Donnez à CCBot son propre groupe User-agent dans robots.txt : les autres robots du même opérateur ont chacun leur réglage.
Comment savoir si CCBot est vraiment bloqué ?
robots.txt n'est qu'une couche : une règle de CDN ou de pare-feu peut aussi refuser un robot, et un robot peut ignorer le fichier. Cherchez le user agent dans votre journal de serveur et testez l'adresse depuis l'extérieur de votre réseau.
Sources
Voyez ce que les IA répondent sur votre boutique
L'audit explore votre site jusqu'à la limite de votre offre, montre quels robots IA il laisse entrer et donne le correctif exact. Dès 9 €, garantie 14 jours.
Auditer mon siteAudit dès 9 €, payé une fois. Garantie 14 jours.