Robots d'exploration IA / Robots d'exploration IA
ClaudeBot : ce qu'il fait et ce que change son blocage
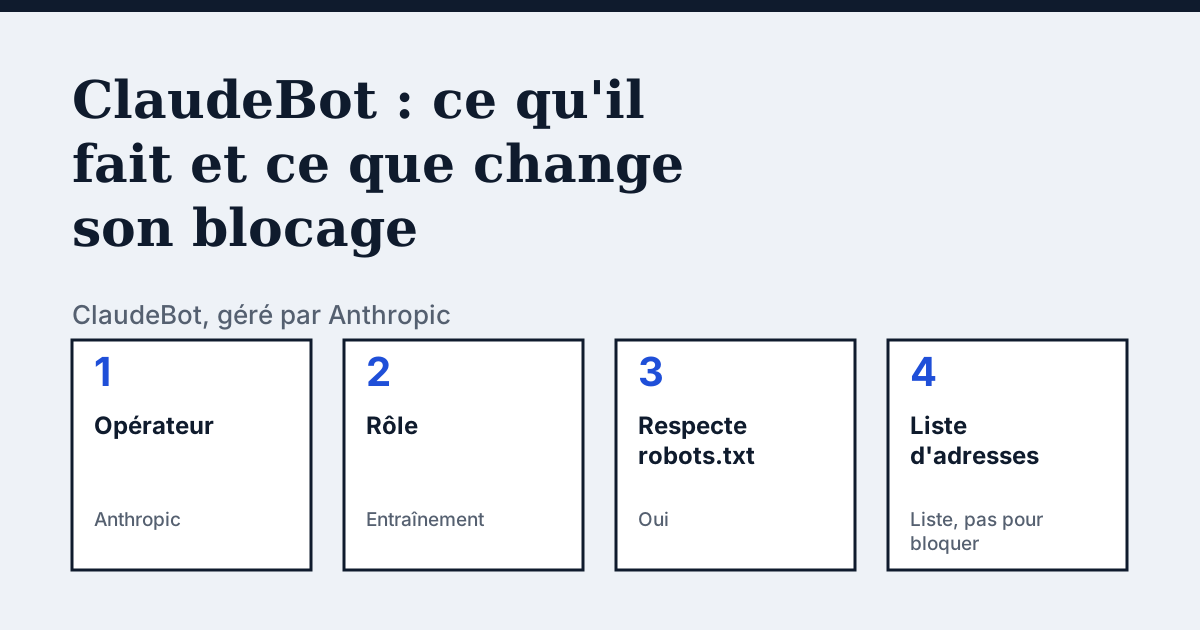
Ce qu'est ClaudeBot
Anthropic nomme trois robots dans son article d’aide : ClaudeBot pour les données d’entraînement, Claude-User pour les pages récupérées à la demande d’un utilisateur, et Claude-SearchBot pour la qualité de la recherche. ClaudeBot est celui de l’entraînement. L’article est daté du 7 avril 2026.
| Fait | ClaudeBot |
|---|---|
| Opérateur | Anthropic |
| Rôle | Entraînement |
| Jeton robots.txt | ClaudeBot |
| Respecte robots.txt | Oui, il suit robots.txt et Crawl-delay |
| Adresses IP | L'opérateur renvoie à une liste mais déconseille le blocage par IP |
| Page de l'opérateur lue le | 21 octobre 2026 |
Ce que dit l'opérateur
Les mots de l'opérateur (original en anglais) : “ClaudeBot helps enhance the utility and safety of our generative AI models by collecting web content that could potentially contribute to their training. When a site restricts ClaudeBot access, it signals that the site's future materials should be excluded from our AI model training datasets.”
Source : Anthropic Help Center: Does Anthropic crawl data from the web, and how can site owners block the crawler? (7 April 2026), lu le 21 octobre 2026.
Que se passe-t-il si vous bloquez ClaudeBot
Anthropic indique qu’une restriction signale que les futurs contenus du site doivent être exclus de ses jeux de données d’entraînement. La formulation dit « futurs contenus » ; elle ne dit pas ce qu’il advient du contenu déjà collecté. Les deux autres robots de Claude sont distincts : bloquer ClaudeBot ne touche donc pas à leurs règles.
Les lignes robots.txt
Pour autoriser ClaudeBot :
User-agent: ClaudeBot
Allow: /
Pour bloquer ClaudeBot :
User-agent: ClaudeBot
Disallow: /
Collez un bloc dans le fichier robots.txt à la racine de votre hôte, par exemple https://example.com/robots.txt. Un groupe pour un jeton ne couvre pas les autres robots du même opérateur.
La page de l'opérateur n'indique pas de chaîne user-agent complète pour ClaudeBot.
Comment distinguer une vraie requête d'une fausse
L’article d’Anthropic indique que ses robots respectent les signaux « ne pas explorer » de robots.txt et ne tenteront pas de contourner les CAPTCHA. Il prend en charge la directive non standard Crawl-delay, par exemple User-agent: ClaudeBot suivi de Crawl-delay: 1. Il précise aussi que bloquer par adresse IP peut ne pas donner un refus durable, car cela empêche le robot de lire robots.txt. L’article d’Anthropic indique que robots.txt doit être défini pour chaque sous-domaine que vous voulez exclure.
À comparer avec Claude-SearchBot
Claude-SearchBot : Un robot de recherche distinct : bloquer ClaudeBot ne le touche pas.
Votre propre site
Le contrôle gratuit dans l'encadré ci-dessus teste ClaudeBot avec une requête réelle et lit robots.txt pour lui. La liste complète des robots est sur le répertoire des robots d'exploration IA.
Questions fréquentes
ClaudeBot respecte-t-il robots.txt ?
Oui, il suit robots.txt et Crawl-delay. Donnez à ClaudeBot son propre groupe User-agent dans robots.txt : les autres robots du même opérateur ont chacun leur réglage.
Comment savoir si ClaudeBot est vraiment bloqué ?
robots.txt n'est qu'une couche : une règle de CDN ou de pare-feu peut aussi refuser un robot, et un robot peut ignorer le fichier. Cherchez le user agent dans votre journal de serveur et testez l'adresse depuis l'extérieur de votre réseau.
Sources
Voyez ce que les IA répondent sur votre boutique
L'audit explore votre site jusqu'à la limite de votre offre, montre quels robots IA il laisse entrer et donne le correctif exact. Dès 9 €, garantie 14 jours.
Auditer mon siteAudit dès 9 €, payé une fois. Garantie 14 jours.