Robots d'exploration IA / Robots d'exploration IA
GoogleOther : ce qu'il fait et ce que change son blocage
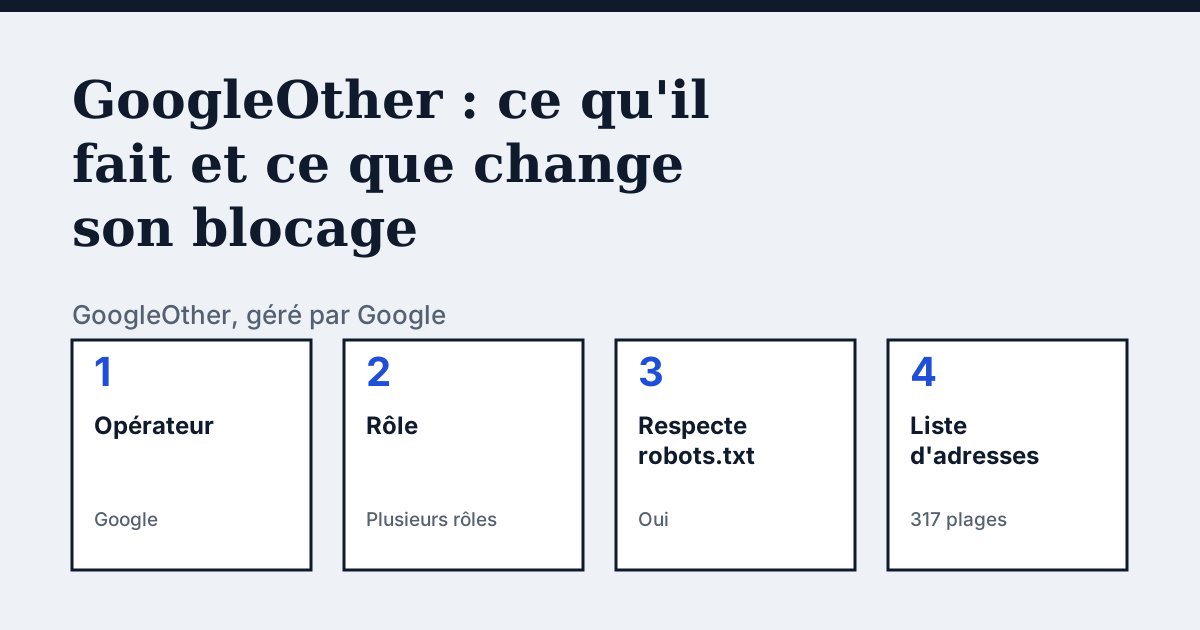
Ce qu'est GoogleOther
GoogleOther est le robot d’exploration générique de Google, utilisé par diverses équipes de produits Google pour récupérer du contenu accessible publiquement, par exemple lors d’explorations ponctuelles pour la recherche et le développement internes. Google le liste parmi ses robots d’exploration courants, à côté de Googlebot, et documente aussi GoogleOther-Image et GoogleOther-Video comme des versions optimisées pour les URL d’images et de vidéos. La page de Google ne dit pas qu’il sert à l’entraînement d’IA.
| Fait | GoogleOther |
|---|---|
| Opérateur | |
| Rôle | Exploration générique pour diverses équipes de produits Google |
| Jeton robots.txt | GoogleOther |
| Respecte robots.txt | Oui. Google indique que les robots d’exploration courants respectent toujours les règles robots.txt lors d’une exploration automatique. |
| Adresses IP | 317 plages (developers.google.com/static/crawling/ipranges/common-crawlers.json, fichier daté du 2026-10-23) |
| Page de l'opérateur lue le | 24 octobre 2026 |
Ce que dit l'opérateur
Les mots de l'opérateur (original en anglais) : “GoogleOther is the generic crawler that may be used by various product teams for fetching publicly accessible content from sites. For example, it may be used for one-off crawls for internal research and development.”
Source : Google Search Central: Google's common crawlers, lu le 24 octobre 2026.
Que se passe-t-il si vous bloquez GoogleOther
Google indique que les préférences d’exploration adressées au user agent GoogleOther n’affectent aucun produit précis. Google documente GoogleOther-Image et GoogleOther-Video comme des jetons robots.txt distincts : il n’est donc pas dit qu’une règle pour GoogleOther les couvre, et le jeton Googlebot est encore un autre jeton.
Les lignes robots.txt
Pour autoriser GoogleOther :
User-agent: GoogleOther
Allow: /
Pour bloquer GoogleOther :
User-agent: GoogleOther
Disallow: /
Collez un bloc dans le fichier robots.txt à la racine de votre hôte, par exemple https://example.com/robots.txt. Un groupe pour un jeton ne couvre pas les autres robots du même opérateur.
La chaîne user-agent indiquée par l'opérateur :
Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; GoogleOther) Chrome/W.X.Y.Z Safari/537.36Comment distinguer une vraie requête d'une fausse
Le fichier developers.google.com/static/crawling/ipranges/common-crawlers.json contenait 317 plages le 24 octobre 2026, fichier daté du 2026-10-23.
Google indique que les robots d’exploration courants explorent généralement depuis les plages de common-crawlers.json, et que le nom DNS inverse correspond à crawl-*-*-*-*.googlebot.com ou geo-crawl-*-*-*-*.geo.googlebot.com.
À comparer avec Googlebot
Googlebot : Googlebot explore pour Google Search et les produits associés, tandis que GoogleOther est un robot générique dont les règles robots.txt n’affectent aucun produit Google précis.
Votre propre site
Le contrôle gratuit dans l'encadré ci-dessus teste huit robots (GPTBot, OAI-SearchBot, ChatGPT-User, PerplexityBot, ClaudeBot, Google-Extended, Bingbot et Googlebot). GoogleOther n'en fait pas partie : lisez votre robots.txt pour un groupe GoogleOther et cherchez le user agent dans votre journal de serveur. La liste complète des robots est sur le répertoire des robots d'exploration IA.
Questions fréquentes
GoogleOther respecte-t-il robots.txt ?
Oui. Google indique que les robots d’exploration courants respectent toujours les règles robots.txt lors d’une exploration automatique. Donnez à GoogleOther son propre groupe User-agent dans robots.txt : les autres robots du même opérateur ont chacun leur réglage.
Comment savoir si GoogleOther est vraiment bloqué ?
robots.txt n'est qu'une couche : une règle de CDN ou de pare-feu peut aussi refuser un robot, et un robot peut ignorer le fichier. Cherchez le user agent dans votre journal de serveur et testez l'adresse depuis l'extérieur de votre réseau.
Sources
- Google Search Central: Google's common crawlers
- Google: common-crawlers.json (read 2026-10-24, creationTime 2026-10-23)
- Google Search Central: Overview of Google crawlers and fetchers
Voyez ce que les IA répondent sur votre boutique
L'audit explore votre site jusqu'à la limite de votre offre, montre quels robots IA il laisse entrer et donne le correctif exact. Dès 9 €, garantie 14 jours.
Auditer mon siteAudit dès 9 €, payé une fois. Garantie 14 jours.