Gidsen / Crawlbaarheid
Is GPTBot geblokkeerd op mijn site? Vier plekken om na te kijken, met een test per plek
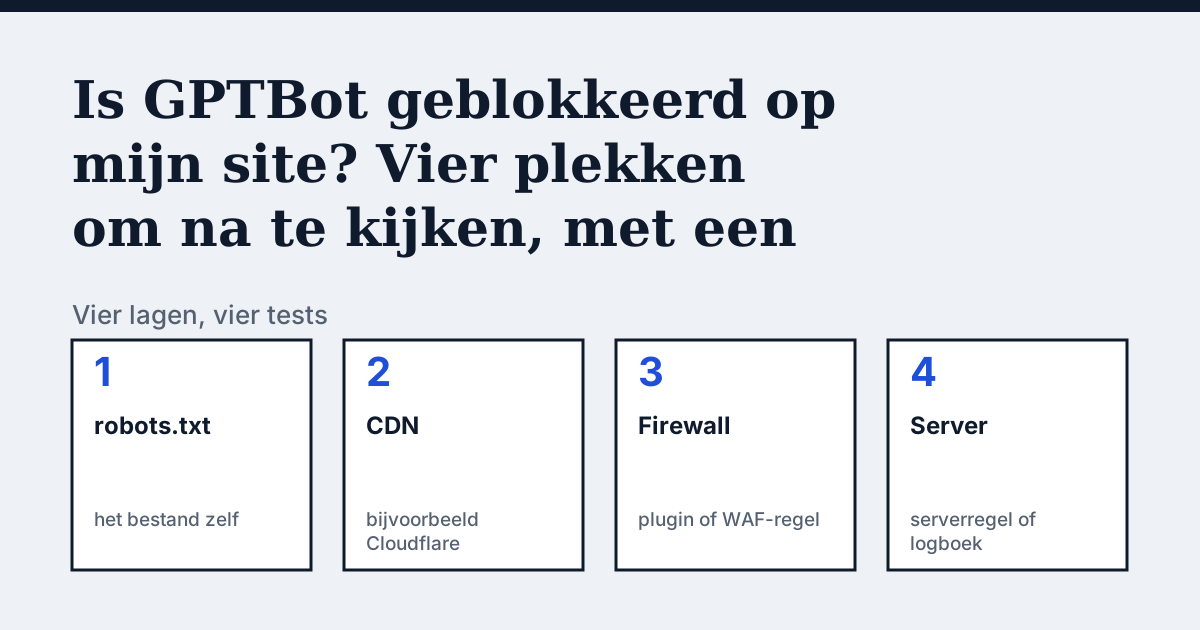
Op welke vier plekken kan GPTBot worden tegengehouden?
GPTBot is de crawler die OpenAI naar eigen zeggen gebruikt om content te verzamelen die gebruikt kan worden om zijn modellen te trainen. Een verzoek van GPTBot kan op vier lagen worden afgewezen en elke laag heeft een eigen test. De audit in het vak hierboven dekt de eerste laag. De andere drie geven een foutcode terug, ook als robots.txt "ja" zegt.
| Laag | Wat u moet nakijken |
|---|---|
| 1. robots.txt | Een groep voor GPTBot of een algemene Disallow: / |
| 2. CDN | De instellingen voor AI-crawlers bij uw CDN |
| 3. Beveiligingsplugin of firewall | Regels die op bot, AI of GPTBot reageren |
| 4. Webserver | Regels in de serverconfiguratie en de logbestanden |
Hoe controleert u of GPTBot geblokkeerd is?
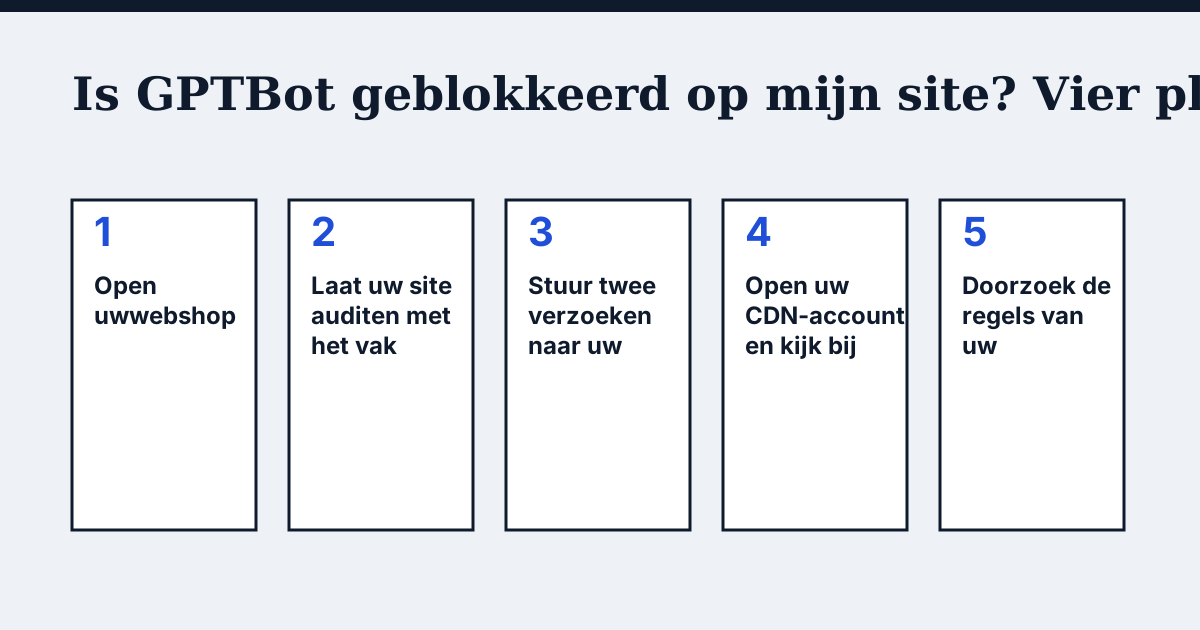
- Open
uwwebshop.nl/robots.txtin een browser. Zoek een groep dieGPTBotnoemt. Is die er niet, dan volgt GPTBot de groepUser-agent: *, dus een algemeneDisallow: /daaronder blokkeert GPTBot ook (RFC 9309). - Laat uw site auditen met het vak hierboven (vanaf €9). De audit leest robots.txt voor GPTBot, OAI-SearchBot, PerplexityBot, Google-Extended en Bingbot en noemt welke geblokkeerd zijn.
- Stuur twee verzoeken naar uw homepage en vergelijk de statuscodes. Eén normaal, één met de user-agent van GPTBot. De opdrachten staan hieronder.
- Open uw CDN-account en kijk bij de instellingen voor AI-crawlers. De stappen voor Cloudflare staan verderop.
- Doorzoek de regels van uw beveiligingsplugin of firewall op
GPTBot,bot,AIencrawler, en zoek in uw serverlogs naarGPTBot. Veel 403-antwoorden aan GPTBot wijzen op een blokkade die robots.txt niet toont.
De test met twee verzoeken
Vervang uwwebshop.nl door uw eigen adres. De eerste opdracht stuurt een gewoon verzoek, de tweede de user-agent die OpenAI voor GPTBot publiceert. Beide tonen alleen de statuscode.
curl -s -o /dev/null -w "%{http_code}\n" https://uwwebshop.nl/
curl -s -o /dev/null -w "%{http_code}\n" -A "Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; GPTBot/1.4; +https://openai.com/gptbot" https://uwwebshop.nl/
Een 403 op alleen het tweede verzoek betekent dat een regel de naam van de crawler als doel heeft.
Houd één beperking in gedachten. Deze test komt van uw eigen computer. Beoordeelt uw hostingpartij crawlers ook op IP-adres, dan kan de echte GPTBot een ander antwoord krijgen dan u zag. OpenAI publiceert de IP-bereiken van GPTBot op openai.com/gptbot.json, zodat u in uw logs kunt zien of verzoeken uit die bereiken zijn doorgekomen (OpenAI-documentatie).
Waar staat de instelling bij Cloudflare?
Volgens de documentatie van Cloudflare opent u uw domein, gaat u naar AI Crawl Control, opent u het tabblad Security en daarna Crawlers. In de kolom Actions kiest u per crawler Allow of Block. Block maakt of wijzigt een WAF-regel en bij Allow kunt u robots.txt nog steeds laten afdwingen (Cloudflare: manage AI crawlers).
De standaardinstellingen van Cloudflare veranderen ook. Help Net Security meldt dat nieuwe domeinen vanaf 15 september 2026 standaard Training- en Agent-crawlers blokkeren op pagina's met advertenties, terwijl Search-crawlers toegelaten blijven (Help Net Security). Kijk dus in uw eigen dashboard welke standaard uw domein heeft gekregen.
Wat als de check zegt dat uw site het verzoek weigerde?
Ook een gewoon verzoek van onze check kan worden geweigerd. Bij HTTP 403, 429 of 503 melden we dat, en dat we van buitenaf niet kunnen zien of AI-crawlers ook geweigerd worden. Een 403 betekent meestal dat een regel het verzoek blokkeerde. Een 429 of 503 kan ook wijzen op rate limiting of een storing, die elke bezoeker raakt. Los de oorzaak op in uw CDN, firewall of hostingpaneel en draai de check opnieuw.
Moet u GPTBot deblokkeren?
Dat beslist u zelf, en blokkeren is een legitieme keuze. OpenAI noemt GPTBot, OAI-SearchBot en ChatGPT-User als aparte crawlers met aparte taken. GPTBot is voor trainingsdata. OAI-SearchBot toont sites in de zoekfuncties van ChatGPT. ChatGPT-User haalt pagina's op wanneer iemand erom vraagt.
| Uw doel | Wat u doet |
|---|---|
| In ChatGPT-zoekresultaten staan, content niet laten trainen | OAI-SearchBot toestaan, GPTBot weigeren |
| In zoekresultaten staan en training toestaan | Beide toestaan |
| Van beide wegblijven | Beide weigeren en uw logs op ChatGPT-User nakijken |
Volgens OpenAI kan een wijziging in robots.txt ongeveer 24 uur duren voordat OAI-SearchBot haar oppikt.
Veelgestelde vragen
Haalt het blokkeren van GPTBot mijn webshop uit ChatGPT?
Niet vanzelf. OpenAI beschrijft OAI-SearchBot als de crawler voor de zoekfuncties van ChatGPT en GPTBot als trainingscrawler. Beide stelt u apart in via robots.txt.
Waarom ziet robots.txt er goed uit en krijgt GPTBot toch een 403?
robots.txt is een verzoek aan de crawler. Een CDN-, firewall- of serverregel kan het verzoek alsnog weigeren. Controleer die lagen met de test met twee verzoeken en uw logs.
Houdt ChatGPT-User zich aan robots.txt?
OpenAI zegt dat robots.txt-regels mogelijk niet gelden voor ChatGPT-User, omdat een persoon die verzoeken start.
Wordt mijn webshop aanbevolen als ik GPTBot deblokkeer?
Nee. Leesbaar zijn is het toegangsbewijs. Of een assistent uw webshop noemt, hangt af van wat hij over uw categorie vindt. De CitedBy-audit meet dat met echte koopvragen.
Bronnen
- OpenAI: crawlers en user agents, IP-bereiken
- Cloudflare: manage AI crawlers
- Help Net Security: Cloudflare past toegangsregels voor AI-crawlers aan, 2 juli 2026
- IETF RFC 9309: Robots Exclusion Protocol
- CitedBy: site-audit
Zie wat AI antwoordt over uw webshop
De audit crawlt elke pagina van uw site, toont welke AI-crawlers binnenkomen en geeft de exacte oplossing. Vanaf €9, 14 dagen geld-terug-garantie.
Audit mijn siteAudit vanaf €9, eenmalig betaald. Fix Pack €390, eenmalig. 14 dagen geld-terug-garantie.