AI-crawlers / AI-crawlers
ChatGPT-User: wat het doet en wat blokkeren verandert
Wat ChatGPT-User is
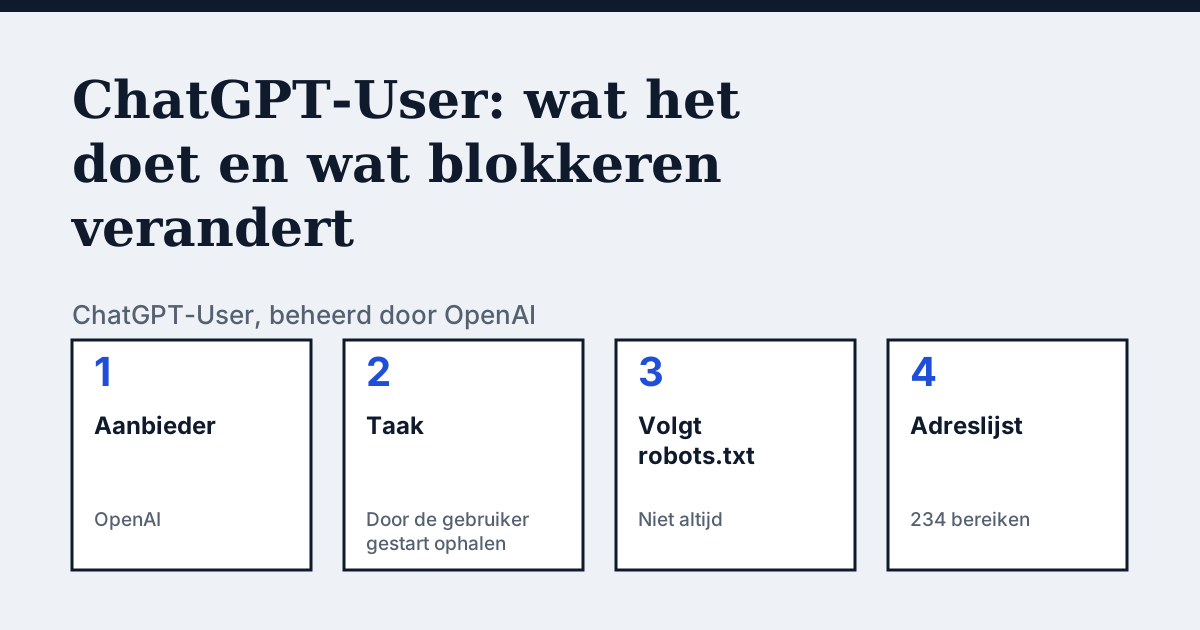
In tegenstelling tot de andere OpenAI-robots struint ChatGPT-User niet zelf over het web. OpenAI beschrijft hem als de agent voor bepaalde gebruikersacties in ChatGPT en aangepaste GPT's, ook voor pagina's die een aangepaste GPT bereikt via GPT Actions. Iemand typte iets en daarna kwam er een verzoek bij je server binnen.
| Gegeven | ChatGPT-User |
|---|---|
| Aanbieder | OpenAI |
| Taak | Door de gebruiker gestart ophalen |
| robots.txt-token | ChatGPT-User |
| Volgt robots.txt | Robots.txt-regels gelden mogelijk niet |
| IP-adressen | 234 bereiken (openai.com/chatgpt-user.json, bestand van 2026-10-20) |
| Pagina van de aanbieder gelezen op | 21 oktober 2026 |
Wat de aanbieder zegt
De woorden van de aanbieder (Engels origineel): “ChatGPT-User is not used for crawling the web in an automatic fashion. Because these actions are initiated by a user, robots.txt rules may not apply.”
Bron: OpenAI: Overview of OpenAI Crawlers, gelezen op 21 oktober 2026.
Wat gebeurt er als je ChatGPT-User blokkeert
Omdat het bezoek door een gebruiker wordt gestart, waarschuwt OpenAI dat robots.txt-regels mogelijk niet gelden. Een regel Disallow voor ChatGPT-User is dus geen gegarandeerde stop. OpenAI zegt ook dat ChatGPT-User niet wordt gebruikt om te bepalen of content in zoekresultaten verschijnt, en verwijst opt-outs voor zoeken naar OAI-SearchBot. Wil je deze verzoeken stoppen, dan regel je dat op je server of CDN, niet alleen in robots.txt.
De robots.txt-regels
Om ChatGPT-User toe te staan:
User-agent: ChatGPT-User
Allow: /
Om ChatGPT-User te blokkeren:
User-agent: ChatGPT-User
Disallow: /
Plak een blok in de robots.txt in de root van je host, bijvoorbeeld https://example.com/robots.txt. Een groep voor één token geldt niet voor de andere crawlers van dezelfde aanbieder.
De user-agent-string volgens de aanbieder:
Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; ChatGPT-User/1.0; +https://openai.com/botHoe je een echt verzoek van een nep-verzoek onderscheidt
De adreslijst is de langste van de drie OpenAI-bestanden die we hebben geteld: openai.com/chatgpt-user.json bevatte op 21 oktober 2026 234 prefixen, met aanmaaktijd 2026-10-20, de dag voor deze pagina. Bij zo'n lange lijst haal je het bestand opnieuw op als je een logregel controleert. Kopieer hem niet eenmalig in een firewall.
Vergelijk met OAI-SearchBot
OAI-SearchBot: OAI-SearchBot is de zoekcrawler en volgt robots.txt wel.
Je eigen site
De gratis check in het kader hierboven test ChatGPT-User met een echt verzoek en leest daarvoor robots.txt. De volledige lijst met crawlers staat in de gids met AI-crawlers.
Veelgestelde vragen
Volgt ChatGPT-User robots.txt?
Niet altijd. Robots.txt-regels gelden mogelijk niet. Een regel voor ChatGPT-User in robots.txt houdt het dus mogelijk niet tegen. Wil je het zeker weigeren, gebruik dan een firewall- of CDN-regel die user agent en gepubliceerde adressen combineert.
Hoe weet ik dat ChatGPT-User echt geblokkeerd is?
robots.txt is maar één laag: ook een CDN- of firewallregel kan een crawler weigeren, en een crawler kan het bestand negeren. Zoek de user agent in je serverlog en test het adres van buiten je netwerk.
Bronnen
Zie wat AI antwoordt over je webshop
De audit crawlt je site tot de paginalimiet van je abonnement, toont welke AI-crawlers binnenkomen en geeft de exacte oplossing. Vanaf €9, 14 dagen geld-terug-garantie.
Audit mijn siteAudit vanaf €9, eenmalig betaald. 14 dagen geld-terug-garantie.