AI-crawlers / AI-crawlers
ClaudeBot: wat het doet en wat blokkeren verandert
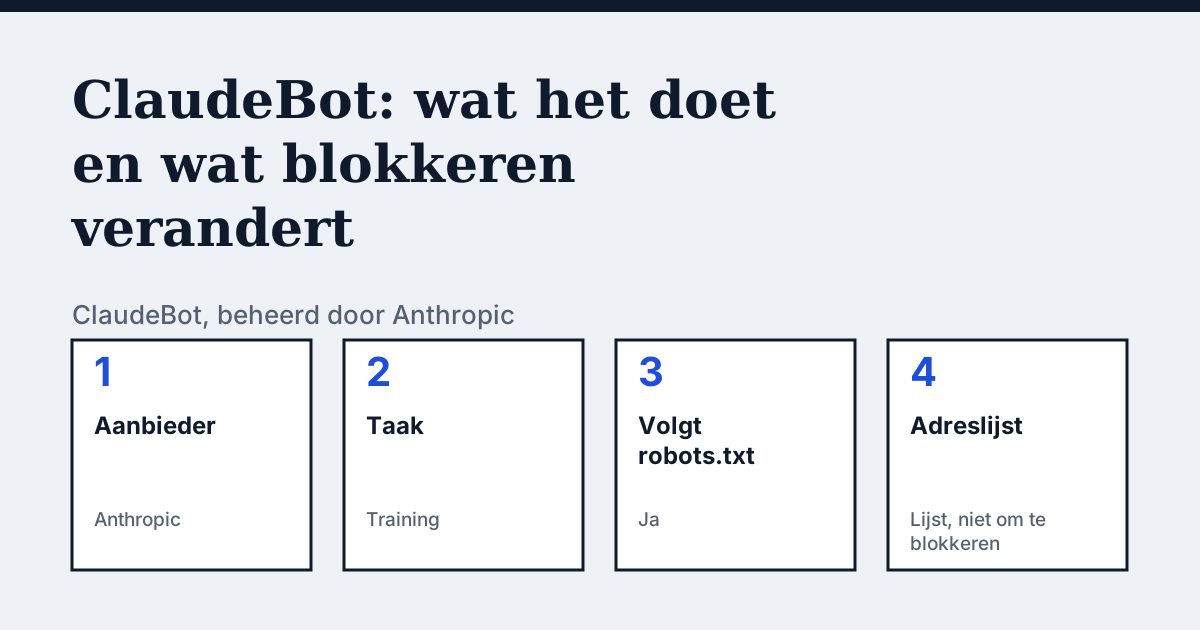
Wat ClaudeBot is
Anthropic noemt in zijn helpartikel drie robots: ClaudeBot voor trainingsdata, Claude-User voor pagina's die op verzoek van een gebruiker worden opgehaald en Claude-SearchBot voor zoekkwaliteit. ClaudeBot is die voor training. Het artikel is gedateerd 7 april 2026.
| Gegeven | ClaudeBot |
|---|---|
| Aanbieder | Anthropic |
| Taak | Training |
| robots.txt-token | ClaudeBot |
| Volgt robots.txt | Ja, volgt robots.txt en Crawl-delay |
| IP-adressen | De aanbieder verwijst naar een lijst maar raadt blokkeren op IP af |
| Pagina van de aanbieder gelezen op | 21 oktober 2026 |
Wat de aanbieder zegt
De woorden van de aanbieder (Engels origineel): “ClaudeBot helps enhance the utility and safety of our generative AI models by collecting web content that could potentially contribute to their training. When a site restricts ClaudeBot access, it signals that the site's future materials should be excluded from our AI model training datasets.”
Bron: Anthropic Help Center: Does Anthropic crawl data from the web, and how can site owners block the crawler? (7 April 2026), gelezen op 21 oktober 2026.
Wat gebeurt er als je ClaudeBot blokkeert
Anthropic zegt dat een beperking aangeeft dat toekomstig materiaal van de site buiten zijn trainingsdatasets moet blijven. De formulering is „toekomstig materiaal“. Er staat niet wat er gebeurt met content die al is verzameld. De andere twee Claude-robots staan los hiervan, dus hun regels veranderen niet als je ClaudeBot blokkeert.
De robots.txt-regels
Om ClaudeBot toe te staan:
User-agent: ClaudeBot
Allow: /
Om ClaudeBot te blokkeren:
User-agent: ClaudeBot
Disallow: /
Plak een blok in de robots.txt in de root van je host, bijvoorbeeld https://example.com/robots.txt. Een groep voor één token geldt niet voor de andere crawlers van dezelfde aanbieder.
De pagina van de aanbieder toont geen volledige user-agent-string voor ClaudeBot.
Hoe je een echt verzoek van een nep-verzoek onderscheidt
Volgens het artikel van Anthropic respecteren zijn robots „niet crawlen“-signalen in robots.txt en proberen ze CAPTCHA's niet te omzeilen. Anthropic ondersteunt de niet-standaard Crawl-delay-regel, bijvoorbeeld User-agent: ClaudeBot gevolgd door Crawl-delay: 1. Anthropic zegt ook dat blokkeren op IP-adres mogelijk geen blijvende opt-out geeft, omdat de robot dan robots.txt niet meer kan lezen. Volgens het artikel van Anthropic moet je robots.txt instellen voor elk subdomein dat je wilt uitsluiten.
Vergelijk met Claude-SearchBot
Claude-SearchBot: Een aparte zoekrobot: als je ClaudeBot blokkeert, verandert er niets voor die robot.
Je eigen site
De gratis check in het kader hierboven test ClaudeBot met een echt verzoek en leest daarvoor robots.txt. De volledige lijst met crawlers staat in de gids met AI-crawlers.
Veelgestelde vragen
Volgt ClaudeBot robots.txt?
Ja, volgt robots.txt en Crawl-delay. Geef ClaudeBot in robots.txt een eigen User-agent-groep: de andere crawlers van dezelfde aanbieder hebben elk hun eigen instelling.
Hoe weet ik dat ClaudeBot echt geblokkeerd is?
robots.txt is maar één laag: ook een CDN- of firewallregel kan een crawler weigeren, en een crawler kan het bestand negeren. Zoek de user agent in je serverlog en test het adres van buiten je netwerk.
Bronnen
Zie wat AI antwoordt over je webshop
De audit crawlt je site tot de paginalimiet van je abonnement, toont welke AI-crawlers binnenkomen en geeft de exacte oplossing. Vanaf €9, 14 dagen geld-terug-garantie.
Audit mijn siteAudit vanaf €9, eenmalig betaald. 14 dagen geld-terug-garantie.