AI-crawlers / AI-crawlers
Meta-ExternalFetcher: wat het doet en wat blokkeren verandert
Wat Meta-ExternalFetcher is
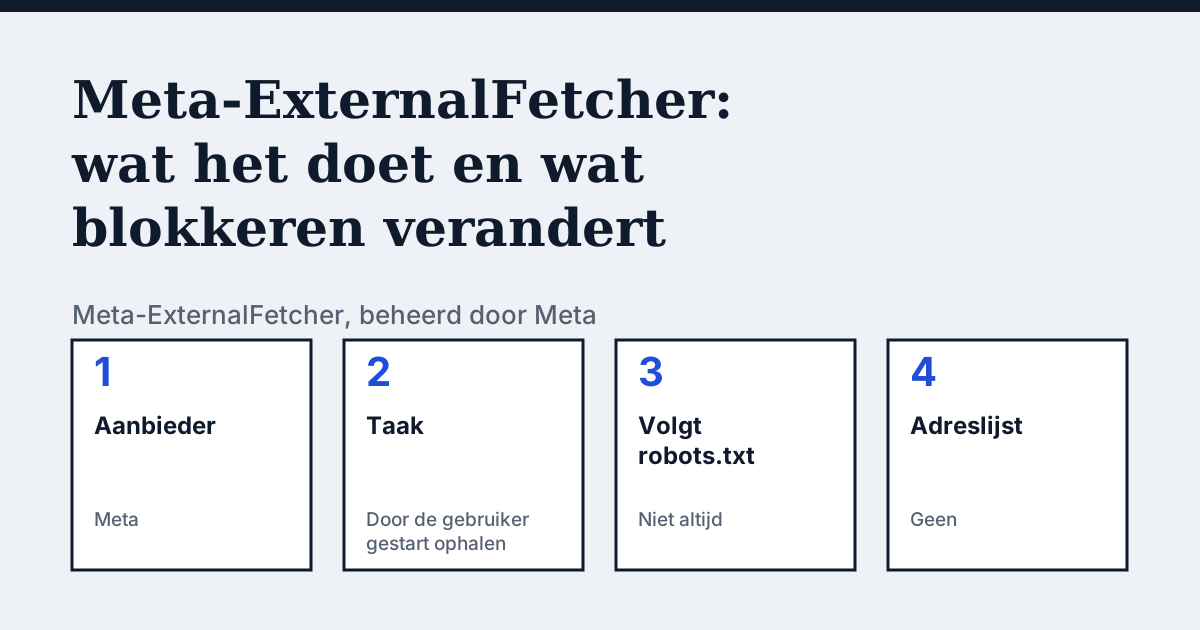
Meta-ExternalFetcher is een Meta-crawler die losse links ophaalt op verzoek van een gebruiker. Meta zegt dat hij productfuncties ondersteunt, zoals het beoordelen en verbeteren van agentische AI-mogelijkheden, waaronder AI helpen websites te doorlopen om taken voor gebruikers af te ronden. Meta beschrijft hem op één pagina samen met Meta-ExternalAgent, Meta-WebIndexer, Meta-ExternalAds en FacebookExternalHit.
| Gegeven | Meta-ExternalFetcher |
|---|---|
| Aanbieder | Meta |
| Taak | Door de gebruiker gestart ophalen |
| robots.txt-token | Meta-ExternalFetcher |
| Volgt robots.txt | Gedeeltelijk, kan robots.txt omzeilen omdat een gebruiker de ophaalacties vraagt |
| IP-adressen | Niet gepubliceerd |
| Pagina van de aanbieder gelezen op | 24 oktober 2026 |
Wat de aanbieder zegt
De woorden van de aanbieder (Engels origineel): “The Meta-ExternalFetcher crawler fetches individual links at a user's request and supports product functions such as evaluating and improving agentic AI capabilities—including helping AI navigate websites to complete tasks for users. Accordingly, this crawler may bypass robots.txt rules.”
Bron: Meta: Meta Web Crawlers, gelezen op 24 oktober 2026.
Wat gebeurt er als je Meta-ExternalFetcher blokkeert
Meta zegt dat je zijn crawlers kunt blokkeren door een disallow voor de betreffende crawler aan robots.txt toe te voegen. Meta zegt ook dat Meta-ExternalFetcher robots.txt kan omzeilen, omdat hij ophaalacties uitvoert die de gebruiker heeft gevraagd. Volgens Meta kunnen wijzigingen in robots.txt tot 24 uur duren, omdat crawlers het bestand tot 24 uur kunnen cachen.
De robots.txt-regels
Om Meta-ExternalFetcher toe te staan:
User-agent: Meta-ExternalFetcher
Allow: /
Om Meta-ExternalFetcher te blokkeren:
User-agent: Meta-ExternalFetcher
Disallow: /
Plak een blok in de robots.txt in de root van je host, bijvoorbeeld https://example.com/robots.txt. Een groep voor één token geldt niet voor de andere crawlers van dezelfde aanbieder.
De user-agent-string volgens de aanbieder:
meta-externalfetcher/1.1Hoe je een echt verzoek van een nep-verzoek onderscheidt
De crawlerpagina van Meta noemt voor deze crawler geen IP-adressen of verificatiemethode. De crawler wordt herkend aan zijn user-agent-string.
Vergelijk met Meta-ExternalAgent
Meta-ExternalAgent: Meta-ExternalAgent crawlt op de achtergrond het web, ook voor het trainen van AI-foundation-modellen, terwijl Meta-ExternalFetcher losse links ophaalt waar een gebruiker om vroeg en robots.txt kan omzeilen.
Je eigen site
De gratis check in het kader hierboven test acht crawlers (GPTBot, OAI-SearchBot, ChatGPT-User, PerplexityBot, ClaudeBot, Google-Extended, Bingbot en Googlebot). Meta-ExternalFetcher is er niet bij: kijk in je robots.txt of er een groep Meta-ExternalFetcher staat en zoek de user agent in je serverlog. De volledige lijst met crawlers staat in de gids met AI-crawlers.
Veelgestelde vragen
Volgt Meta-ExternalFetcher robots.txt?
Niet altijd. Gedeeltelijk, kan robots.txt omzeilen omdat een gebruiker de ophaalacties vraagt. Een regel voor Meta-ExternalFetcher in robots.txt houdt het dus mogelijk niet tegen. Wil je het zeker weigeren, gebruik dan een firewall- of CDN-regel die user agent en gepubliceerde adressen combineert.
Hoe weet ik dat Meta-ExternalFetcher echt geblokkeerd is?
robots.txt is maar één laag: ook een CDN- of firewallregel kan een crawler weigeren, en een crawler kan het bestand negeren. Zoek de user agent in je serverlog en test het adres van buiten je netwerk.
Bronnen
Zie wat AI antwoordt over je webshop
De audit crawlt je site tot de paginalimiet van je abonnement, toont welke AI-crawlers binnenkomen en geeft de exacte oplossing. Vanaf €9, 14 dagen geld-terug-garantie.
Audit mijn siteAudit vanaf €9, eenmalig betaald. 14 dagen geld-terug-garantie.