AI-crawlers / AI-crawlers
Google-Extended: wat het doet en wat blokkeren verandert
Wat Google-Extended is
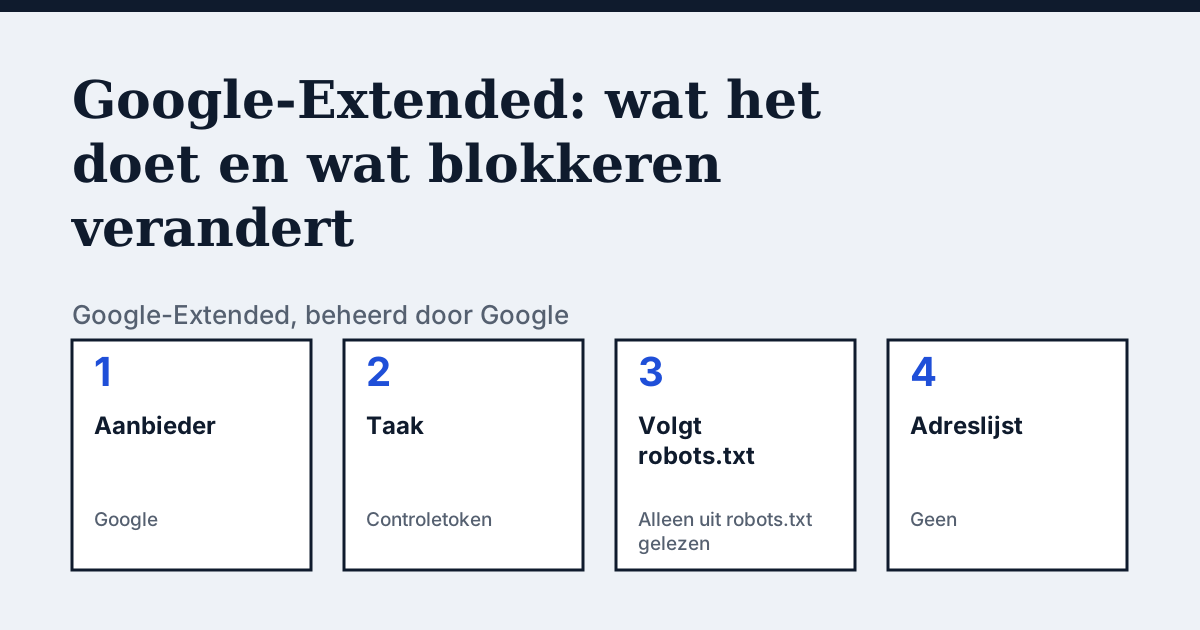
De meeste pagina's in deze set beschrijven een crawler die je in een log kunt vinden. Deze niet. Google zegt dat Google-Extended „geen aparte HTTP-user-agent-string heeft“: het crawlen gebeurt met bestaande Google-user agents en het robots.txt-token heeft een controlerende functie.
| Gegeven | Google-Extended |
|---|---|
| Aanbieder | |
| Taak | Controletoken (doet zelf geen verzoeken) |
| robots.txt-token | Google-Extended |
| Volgt robots.txt | Wordt alleen uit robots.txt gelezen; er is geen aparte user agent |
| IP-adressen | Geen: het haalt nooit pagina's op |
| Pagina van de aanbieder gelezen op | 21 oktober 2026 |
Wat de aanbieder zegt
De woorden van de aanbieder (Engels origineel): “Google-Extended is a standalone product token that web publishers can use to manage whether content Google crawls from their sites may be used for training future generations of Gemini models that power Gemini Apps and Vertex AI API for Gemini. Google-Extended does not impact a site's inclusion in Google Search nor is it used as a ranking signal in Google Search.”
Bron: Google Search Central: Google's common crawlers (last updated 2026-10-15), gelezen op 21 oktober 2026.
Wat gebeurt er als je Google-Extended blokkeert
Met Disallow: / onder Google-Extended laat je Google weten dat de content niet mag worden gebruikt om toekomstige Gemini-modellen achter Gemini Apps en de Vertex AI API for Gemini te trainen. Google zegt ook dat het geen invloed heeft op opname in Google Search en geen rangschikkingssignaal is. Onze audit leest dit token in robots.txt als een van de controles. Het is het enige signaal dat er is.
De robots.txt-regels
Om Google-Extended toe te staan:
User-agent: Google-Extended
Allow: /
Om Google-Extended te blokkeren:
User-agent: Google-Extended
Disallow: /
Plak een blok in de robots.txt in de root van je host, bijvoorbeeld https://example.com/robots.txt. Een groep voor één token geldt niet voor de andere crawlers van dezelfde aanbieder.
Hoe je een echt verzoek van een nep-verzoek onderscheidt
Op netwerkniveau valt hier niets te verifiëren: geen user agent, geen adreslijst. Controleer robots.txt zelf, op elke host, en onthoud dat een zoekopdracht in je log naar Google-Extended niets vindt, of je het token nu blokkeert of niet. In het eigen voorbeeld van Google krijgt het token een allow-pad en een disallow-pad, net als elk ander token.
Google-Extended stuurt zelf geen verzoeken en staat dus nooit in je serverlog. Het wordt alleen uit robots.txt gelezen.
Vergelijk met Googlebot
Googlebot: De crawler die je pagina's echt ophaalt voor Search.
Je eigen site
De gratis check in het kader hierboven test Google-Extended met een echt verzoek en leest daarvoor robots.txt. De volledige lijst met crawlers staat in de gids met AI-crawlers.
Veelgestelde vragen
Volgt Google-Extended robots.txt?
Wordt alleen uit robots.txt gelezen; er is geen aparte user agent. Het stuurt zelf geen verzoeken, dus er valt niets te blokkeren in de firewall: de regel in robots.txt is de hele regeling.
Hoe weet ik dat Google-Extended echt geblokkeerd is?
robots.txt is maar één laag: ook een CDN- of firewallregel kan een crawler weigeren, en een crawler kan het bestand negeren. Zoek de user agent in je serverlog en test het adres van buiten je netwerk.
Bronnen
Zie wat AI antwoordt over je webshop
De audit crawlt je site tot de paginalimiet van je abonnement, toont welke AI-crawlers binnenkomen en geeft de exacte oplossing. Vanaf €9, 14 dagen geld-terug-garantie.
Audit mijn siteAudit vanaf €9, eenmalig betaald. 14 dagen geld-terug-garantie.