AI-crawlers / AI-crawlers
Googlebot: wat het doet en wat blokkeren verandert
Wat Googlebot is
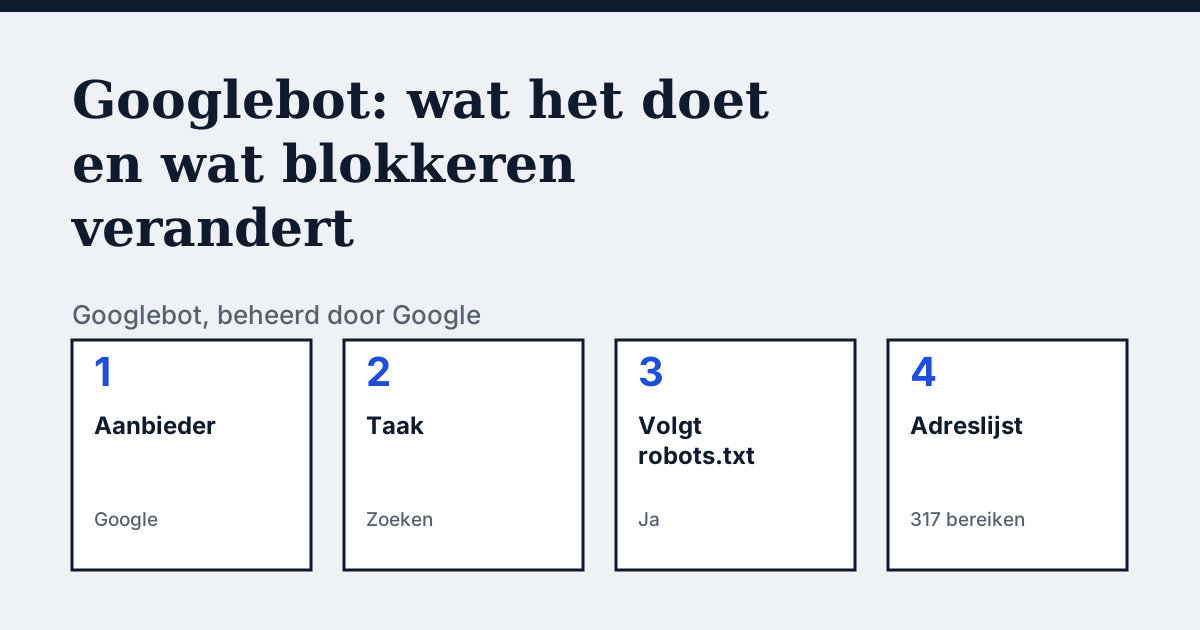
Googlebot is de crawler waar elke controle voor Search mee begint. Op de pagina van Google staan meerdere crawlers. Het ene token Googlebot bepaalt Search, Discover en de producten die op dezelfde crawl leunen, zoals Images, de Video-modus en News.
| Gegeven | Googlebot |
|---|---|
| Aanbieder | |
| Taak | Zoeken (ook Images, Video, News, Discover) |
| robots.txt-token | Googlebot |
| Volgt robots.txt | Ja, altijd bij automatisch crawlen |
| IP-adressen | 317 bereiken (developers.google.com/static/search/apis/ipranges/googlebot.json, bestand van 2026-10-20) |
| Pagina van de aanbieder gelezen op | 21 oktober 2026 |
Wat de aanbieder zegt
De woorden van de aanbieder (Engels origineel): “Google's common crawlers are used to find information for building Google's search indexes, perform other product specific crawls, and for analysis. They always obey robots.txt rules when crawling automatically.”
Bron: Google Search Central: Google's common crawlers (last updated 2026-10-15), gelezen op 21 oktober 2026.
Wat gebeurt er als je Googlebot blokkeert
Een Disallow voor Googlebot is geen smalle AI-opt-out. Het raakt Google Search zelf, inclusief Discover en de functies die erop bouwen, volgens de lijst van getroffen producten van Google. De smallere instelling voor Gemini-training is het aparte token Google-Extended.
De robots.txt-regels
Om Googlebot toe te staan:
User-agent: Googlebot
Allow: /
Om Googlebot te blokkeren:
User-agent: Googlebot
Disallow: /
Plak een blok in de robots.txt in de root van je host, bijvoorbeeld https://example.com/robots.txt. Een groep voor één token geldt niet voor de andere crawlers van dezelfde aanbieder.
De user-agent-string volgens de aanbieder:
Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)Hoe je een echt verzoek van een nep-verzoek onderscheidt
Google publiceert de bereiken die zijn algemene crawlers gebruiken. Het Googlebot-bestand bevatte op 21 oktober 2026 317 prefixen, met aanmaaktijd 2026-10-20 14:46 UTC. Google beschrijft ook een reverse DNS-masker om een hostnaam te bevestigen. Een verzoek controleer je dus op twee manieren: het adres tegen het bestand en de reverse lookup tegen het masker. De pagina zelf is voor het laatst bijgewerkt op 2026-10-15.
Vergelijk met Google-Extended
Google-Extended: Een controletoken voor Gemini-training. Het haalt nooit een pagina op.
Je eigen site
De gratis check in het kader hierboven test Googlebot met een echt verzoek en leest daarvoor robots.txt. De volledige lijst met crawlers staat in de gids met AI-crawlers.
Veelgestelde vragen
Volgt Googlebot robots.txt?
Ja, altijd bij automatisch crawlen. Geef Googlebot in robots.txt een eigen User-agent-groep: de andere crawlers van dezelfde aanbieder hebben elk hun eigen instelling.
Hoe weet ik dat Googlebot echt geblokkeerd is?
robots.txt is maar één laag: ook een CDN- of firewallregel kan een crawler weigeren, en een crawler kan het bestand negeren. Zoek de user agent in je serverlog en test het adres van buiten je netwerk.
Bronnen
- Google Search Central: Google's common crawlers (last updated 2026-10-15)
- developers.google.com/static/search/apis/ipranges/googlebot.json
Zie wat AI antwoordt over je webshop
De audit crawlt je site tot de paginalimiet van je abonnement, toont welke AI-crawlers binnenkomen en geeft de exacte oplossing. Vanaf €9, 14 dagen geld-terug-garantie.
Audit mijn siteAudit vanaf €9, eenmalig betaald. 14 dagen geld-terug-garantie.